
最新动态
Latest news
最近我把一个 3.2 亿参数的开源决策模型部署到了爱芯元智 AX8850 上,然后让它玩贪吃蛇。
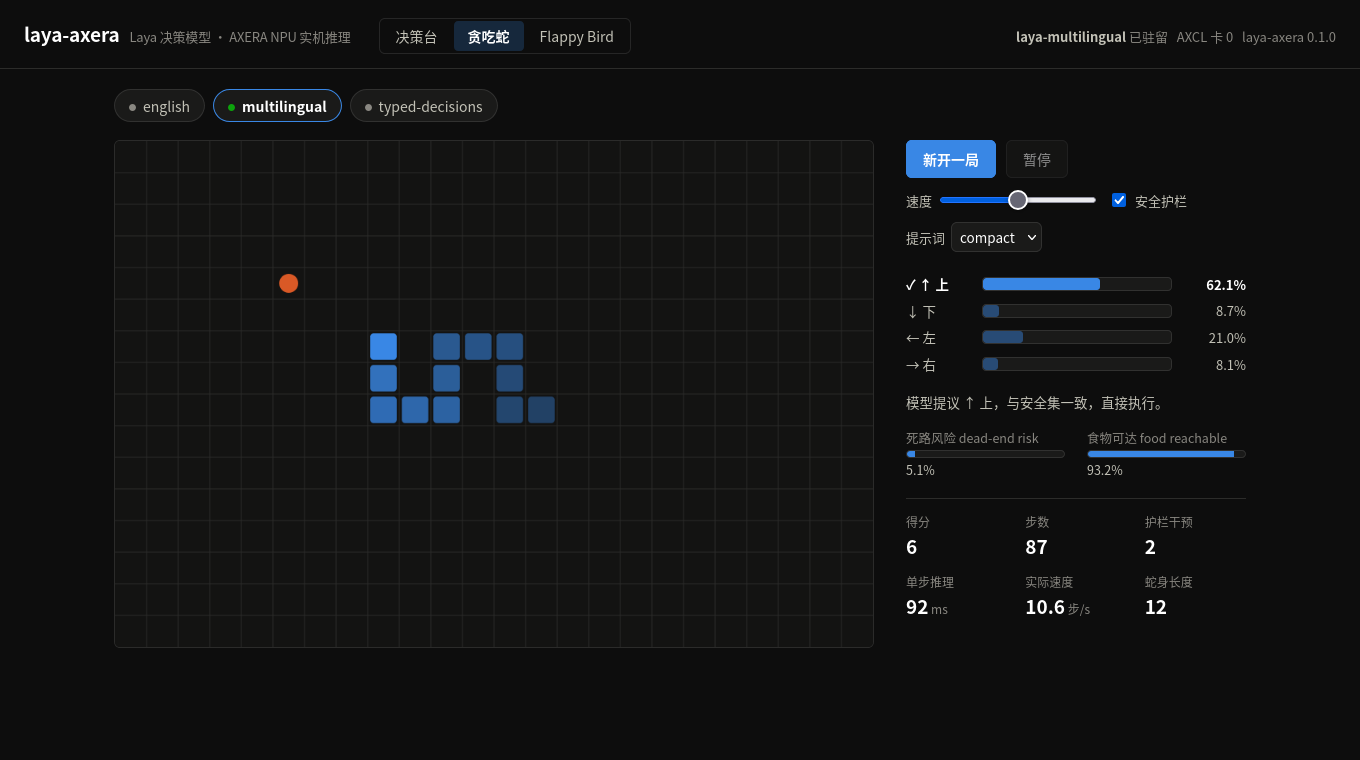
这条蛇背后没有寻路算法替它做决定:每走一步,浏览器把当前局面发给板子,模型在 NPU 上做三次前向推理,输出四个方向的概率,蛇沿概率最高的方向走。单步 90 毫秒出头,约 10 步/秒——全程发生在一颗边缘芯片上,不联网、不调云端 API。
这个模型叫 Laya。如果你关注过 TypeSafe AI 刚发布的决策模型 Jev——那个不生成文本、直接返回类型化答案的「System One」API——Laya 就是这套范式的开源实现:同样的 state + questions 请求,同样的 choice / score / noul 三件套,同样返回校准概率。区别在于:Jev 闭源、只有云端 API,而这里整套东西跑在你自己的一颗边缘芯片上,单问题 28.75ms,比走一趟云端往返快得多。
这篇文章把这个 demo 拆开讲:模型是什么、在 NPU 上怎么跑、贪吃蛇怎么「玩」、实测数据是多少。文末有完整开源代码和三行复现命令。
一、为什么不用 LLM
边缘侧的真实业务,大多数时候要的不是「一篇作文」,而是「一个判断」:这条工单派给哪个组?这条内容过不过审?这个告警定几级?
用 LLM 做这类事,你得让它生成一段 JSON,再解析、再兜底格式错误;几十上百个 token 的自回归解码,延迟和确定性都不友好。
这个方向今年已经被验证过一次:TypeSafe AI 九月发布的 Jev 专门做这件事,他们称之为「System One」模型——不写作文,直接返回带校准概率的类型化答案,发布没几天 LangChain 等生态就跟进了接入教程。但 Jev 闭源,只有云端 API。
Laya(Convai Innovations 开源)是同一套范式的开源实现,叫类型化决策(typed decisions):双向编码器加决策头,一次前向直接输出概率分布,0 个输出 token,请求格式和 Jev 如出一辙——连 Python 方法名都叫 `system_one`。它只回答三种「类型」的问题:
choice:从 2~4 个命名选项里选一个,给出全量概率;
score:在 2~4 档有序量表上打分,给出期望值;
noul:判断一个命题成立的概率 P(true)。
问题用 JSON 描述即可,不用重新训练,换个业务改两行 JSON。官方提供三个 checkpoint:english(ModernBERT-large,4.2 亿参数)、multilingual(mmBERT-base,3.2 亿参数,中文用它)和 typed-decisions。爱芯官方把三者都编译成了 NPU 直接可跑的 axmodel,开源在 Hugging Face(AXERA-TECH/Laya)。
二、它在 NPU 上怎么跑
这个模型对 NPU 特别友好,核心原因一个词:固定形状。
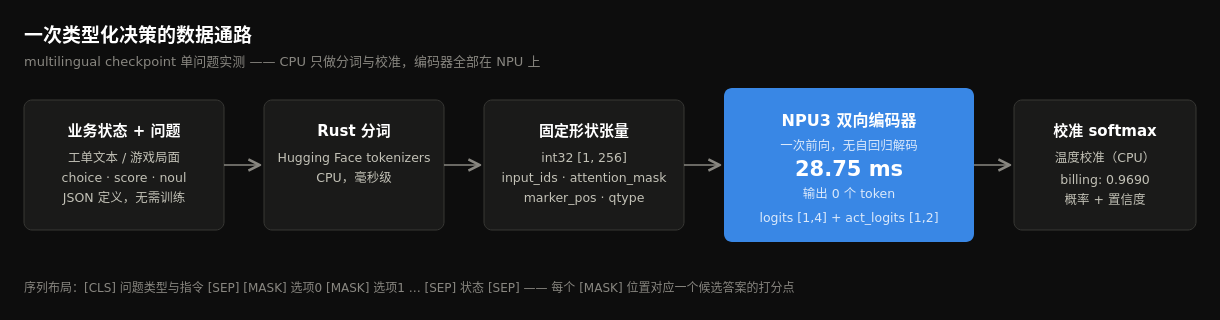
每个问题被序列化成一条固定 256 token 的序列:
//代码开始
[CLS] 问题类型与指令 [SEP] [MASK] 选项0 [MASK] 选项1 … [SEP] 业务状态 [SEP]
//代码结束
宿主侧用官方的 PyAXEngine(Python),核心就这几行:
//代码开始
import laya_axera as laya
agent = laya.load("models/Laya/multilingual")
result = agent.predict(
"发票4411重复扣款,请今天退还多扣的金额。",
{
"department": {
"type": "choice",
"instructions": "这条请求应由哪个团队处理?",
"criteria": {"billing": "扣款与退款", "technical": "故障报错"},
},
"refund": {"type": "noul", "instructions": "用户是否明确要求退款?"},
},
)
# result["answers"]["department"]["choice"] -> "billing"
//代码结束
CPU 只做两件事:Rust tokenizer 分词(毫秒级)和最后的温度校准 softmax。编码器的全部计算都在 NPU 上。
三、贪吃蛇是怎么「玩」的
demo 里三方分工非常清楚:
规则引擎(纯 Python)负责陈述事实:哪些方向合法、哪些安全、食物在哪、空地是否连通(BFS);
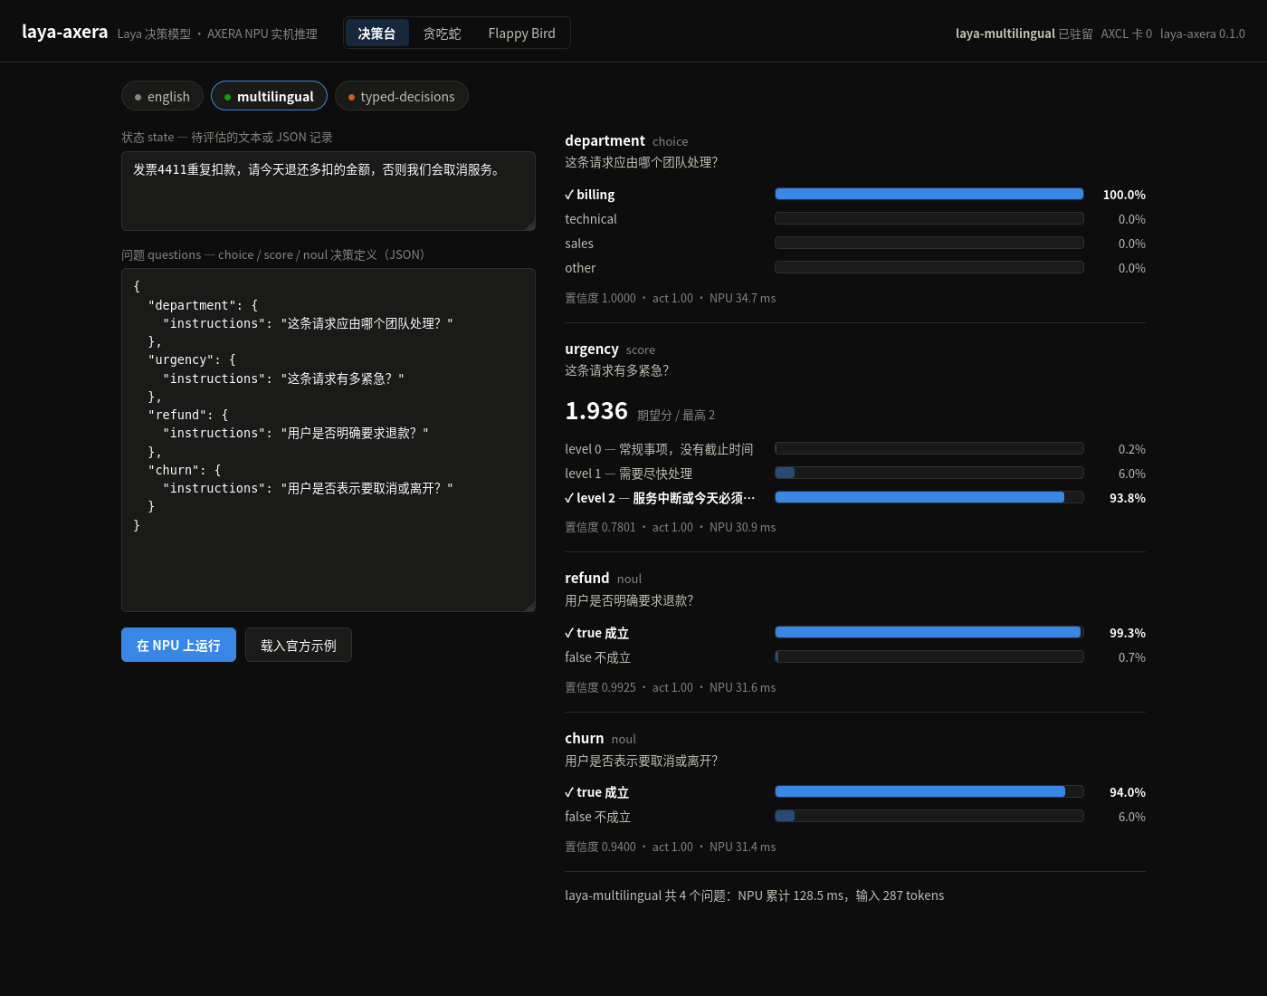
Laya 负责判断:每一步问模型三个问题——move(choice,四个方向各附一句事实描述)、risk(noul,前方还有安全路线吗)、food(noul,食物从空地可达吗);
安全护栏(可关闭):基于汉密顿回路的确定性规划器,只在模型提议撞墙、钻死路时出手纠正,每次干预都被记录并显示在界面上。
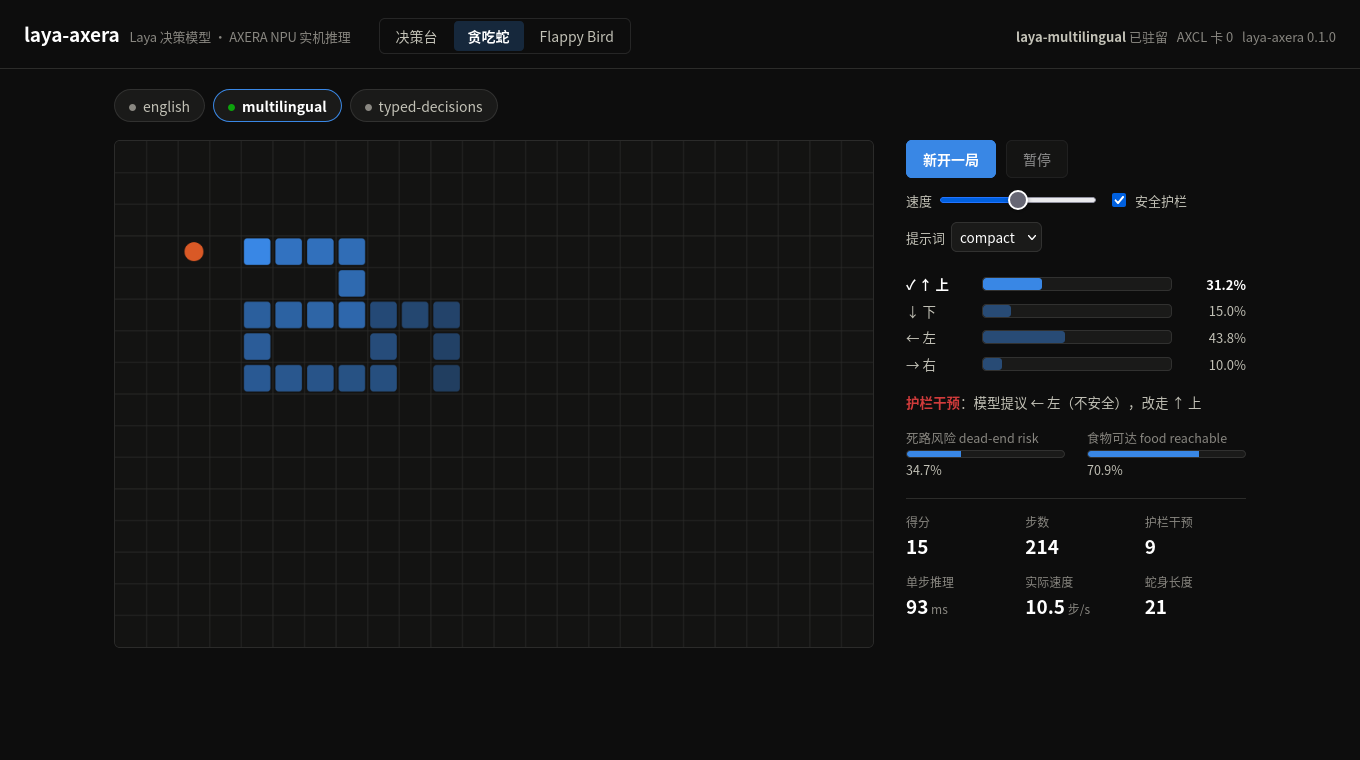
上图是护栏出手的一个瞬间:蛇身 21 格时模型提议向左(概率 43.8%,但那是条死路),护栏把它改成向上,界面红字标出,干预计数加一。
贪吃蛇本身不是重点。重点是这套**「模型给概率、规则兜底、干预可审计」**的结构——它就是边缘业务里「AI 判断 + 业务护栏」的标准形态,贪吃蛇只是把它做成了肉眼可见的样子。
一步三问 ≈ 3 × 28.75ms + 分词开销 ≈ 90ms,这就是界面上「单步推理 93ms」的来源。
四、又加了一只 Flappy Bird
贪吃蛇跑通之后,顺手又加了一个 Flappy Bird:每一步就一个二选一——拍翅还是滑翔。规则引擎推演两个动作的后果,模型读描述做选择,一步只问一个问题,决策频率是贪吃蛇的三倍。
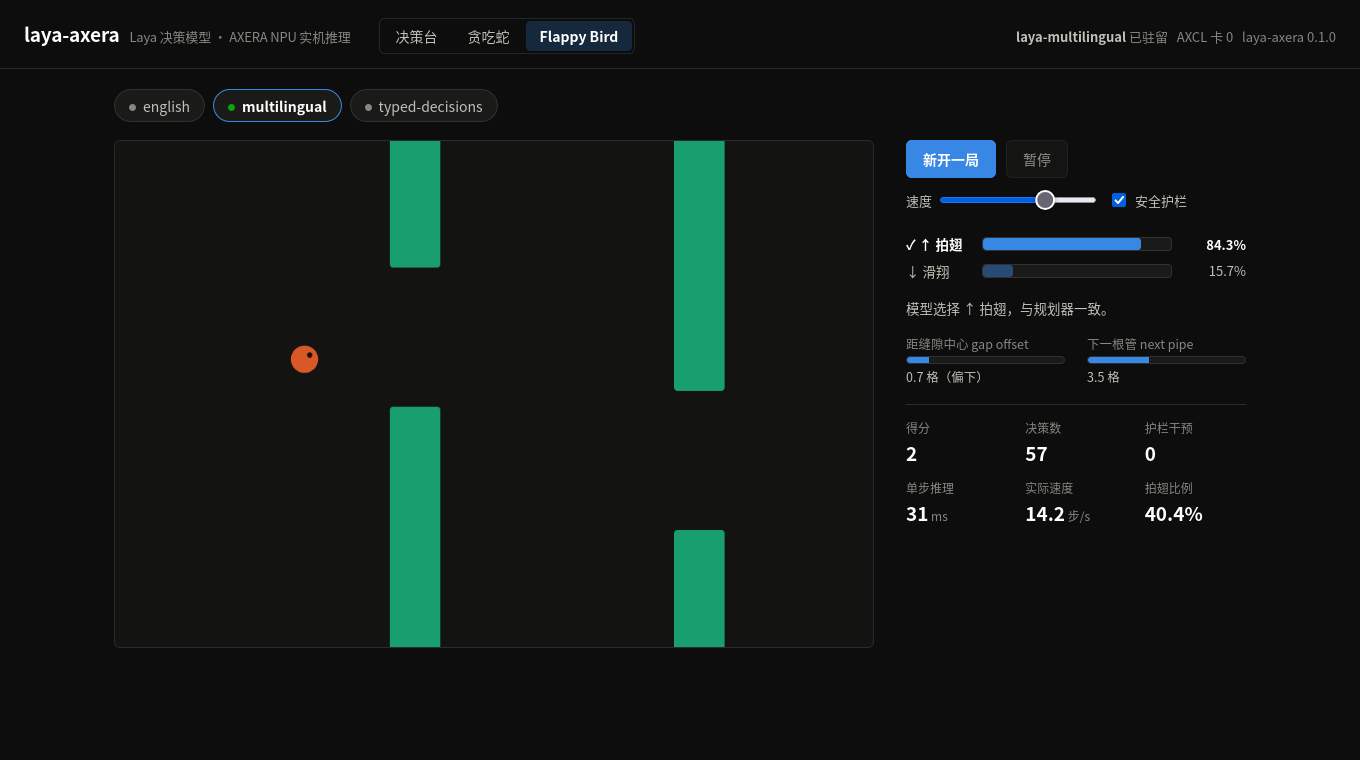
有意思的是调通它的过程。第一版小鸟连第一根管子都过不去(不开护栏时活不过 5 步)——概率探测下来,问题全在措辞上:这个 3.2 亿参数的小模型对词面极其敏感,「flap」这个词本身就强烈吸概率(把它的描述写成 "Wrong.",模型还是给它 0.80);状态文本里的 "falling"、"below" 又会和选项词发生词法串扰。改成中性的 up / down 标签、极简状态、后果全部放进三档固定句式的描述之后,同一个模型直接从秒死变成满分:三个随机种子全部 300 步满程存活、穿过 13 根管子,安全护栏一次都没触发——把护栏关掉也一样。
对这类小决策模型,提示措辞不是玄学,是需要拿概率实测去标定的工程参数。好在它推理只要 30ms,把候选措辞全部跑一遍也就几秒钟——这种「用 NPU 的速度做提示工程」的开发体验,换成云端按次计费的 API 是很难这么奢侈的。
五、实测数据
以下数据在 AX8850 平台的两种部署形态上实测:基于 AX8850 的 爱芯派Pro或者AI-Pyramid Pro,以及 x86主机/树莓派5 + 基于AX8850 的M.2算力卡(使用AXCL软件栈)。
有些细节需要说明下:
一是抖动。 片上连续 40 次推理,最快 28.67ms、最慢 28.96ms,p50 与 max 相差不到 0.3ms。固定形状图的这种确定性,是生成式模型给不了的——做实时业务的同学知道这意味着什么。
二是吞吐。 单问题 28.75ms,即单卡每秒 30+ 个判断,这还是 batch=1 的数字。换算成业务:一条客服工单问满四个问题(部门、紧急度、是否退款、流失风险),NPU 累计约 115ms 出全套结构化结论。
三是跟云端决策 API 比。Jev 官方对速度的描述是「远小于一秒」——那是含网络往返的云端数字,而且按调用计费、数据要出网。本地 NPU 这套:单问题 28.75ms、抖动亚毫秒、断网照跑、数据不出设备,硬件是一次性成本。「开源平替」不只是省钱,是把延迟、隐私和可用性一起收回到自己手里。
六、两种部署形态,一份代码
这个 demo 把 AX8850 的两种用法都跑通了:
AX8850 独立部署:模型、tokenizer、Web 服务全在板子上,浏览器直连板子 IP。适合一体机、边缘盒子。
AX8850 AXCL算力卡:M.2/PCIe 形态插进现有 x86/ARM 主机,业务跑在主机上,推理下放到卡里;一台主机可以插多张卡,卡间互不干扰(demo 用的主机插了 8 张)。
两种形态共用同一份 Python 代码,PyAXEngine 自动选择运行时,切换只是换一个 `device_id`。
七、复现
//代码开始
git clone https://github.com/AXERA-TECH/laya-axera && cd laya-axera
pip install -e '.[web]' # 另需安装 pyaxengine 的 axengine wheel
hf download AXERA-TECH/Laya --local-dir models/Laya
laya-axera serve --root models/Laya --port 8010
//代码结束
浏览器打开 8010 端口,就是文中的界面:决策台随便造工单,贪吃蛇点「新开一局」。
相关链接:
示例代码:
https://github.com/AXERA-TECH/laya-axera
模型转换示例:
https://github.com/AXERA-TECH/laya.axera
模型包:
https://huggingface.co/AXERA-TECH/Laya
https://modelscope.cn/models/AXERA-TECH/Laya

